Chatbot IA Drupal pour sites Drupal existants
Votre site Drupal définit quel contenu est valide, qui peut le consulter et quelle révision est publiée. Un chatbot connecté doit respecter les mêmes règles. Commencez par un contenu ciblé et des scénarios d’accès Drupal réels.
Un chatbot Drupal doit comprendre plus que le texte des pages

Le contenu Drupal est structuré
Les informations visibles sur une page peuvent provenir de nodes, Paragraphs, termes de taxonomie, médias, fichiers, entités référencées et champs personnalisés. Le connecteur doit préserver cette structure assez finement pour retrouver le bon passage et citer la bonne page.

L’accès Drupal est contextuel
Rôles, groupes, abonnements, propriété, grants personnalisés et systèmes d’identité externes peuvent changer ce que chaque personne voit. Ces règles doivent filtrer les sources candidates avant que leur texte n’atteigne le modèle de langage.

Le contenu Drupal évolue en continu
Les rédacteurs créent des révisions, publient des traductions, remplacent des fichiers, dépublient des pages et suppriment des entités. L’index doit ajouter, mettre à jour et retirer des enregistrements à mesure que ces événements se produisent.
Ce que l’intégration chatbot IA Drupal doit respecter
Avant de connecter la récupération, nous alignons la frontière Drupal: quelles entités alimentent l’index, comment l’accès est évalué et quels événements maintiennent les enregistrements à jour.
- Content types, Paragraph types, champs, médias, fichiers, taxonomie et langues dans le périmètre
- Rôles, groupes, abonnements, grants personnalisés et contexte d’identité pour la récupération
- Enregistrement, publication, traduction, changement d’accès, remplacement de fichier, dépublication et suppression

Périmètre de contenu
Nous identifions les content types, bundles, types Paragraph, champs, médias, fichiers, taxonomie et entités référencées susceptibles de soutenir une réponse. Les brouillons et champs administratifs restent hors périmètre, sauf si le cas d’usage convenu l’exige.

Représentation du contenu
Nous définissons comment transformer les données Drupal structurées en enregistrements consultables. Chaque enregistrement peut conserver l’ID d’entité, l’URL canonique, le titre, la section, le content type, la langue, la révision et les métadonnées nécessaires à la récupération et aux citations.

Modèle d’accès
Nous documentons l’accès anonyme, les rôles authentifiés, les groupes, les abonnements, les grants personnalisés et tout service d’identité ou d’habilitation impliqué dans la décision. Des données d’accès manquantes signifient qu’aucun contexte restreint n’est renvoyé.

Événements de changement
Nous cartographions ce qui doit se produire après un enregistrement, une publication, une nouvelle traduction, un grant modifié, un remplacement de fichier, une dépublication ou une suppression. Un job de réconciliation peut détecter les enregistrements manqués par la mise à jour pilotée par événements.
Comment le contenu Drupal devient une réponse citée
Choisir la voie d’intégration pour votre stack Drupal
Nous choisissons la voie après revue de l’architecture Drupal actuelle et de la première collection de contenu.

Étendre la configuration de recherche existante
Un site qui utilise déjà Drupal Search API, Solr, Elasticsearch ou un autre index adapté peut réutiliser une partie de cette configuration. Nous examinons champs, filtres d’accès, gestion des langues, latence de mise à jour et prise en charge des métadonnées de récupération dont le chatbot a besoin.

Ajouter un connecteur spécifique à Drupal
Un connecteur sur mesure peut gérer des Paragraphs imbriqués, des entités personnises, des fichiers externes, des règles de publication atypiques ou une logique d’accès fine. Il donne à l’intégration un contrat explicite pour ajouts, mises à jour, suppressions et citations.

Utiliser un service de récupération séparé
Drupal reste la source du contenu et des décisions d’accès, tandis qu’un autre service gère le découpage, les embeddings, le classement et les appels au modèle. La frontière définit la propriété des données, les identifiants, les logs, la gestion des erreurs et le contrôle d’accès final.

Après la revue d’architecture
Nous choisissons la voie après revue de l’architecture Drupal actuelle et de la première collection de contenu
Ce qu’un pilote chatbot Drupal doit prouver
Avant un déploiement plus large, le pilote doit confirmer indexation, synchronisation, accès et citations sur du contenu et des utilisateurs Drupal réels.
Le connecteur lit le contenu prévu.
Le pilote indexe un ensemble convenu de content types, champs, fichiers, langues et références. Des enregistrements échantillons montrent quelle source Drupal a produit chaque passage consultable.
Les changements éditoriaux atteignent l’index
Les rédacteurs s’attendent à ce que les réponses reflètent ce qu’ils viennent de publier. Le pilote exécute des changements Drupal contrôlés et vérifie que l’index de recherche suit chaque événement.
Les changements éditoriaux atteignent l’index.
Les tests couvrent une nouvelle entité, un champ modifié, une nouvelle révision, une traduction, une page dépubliée, un élément supprimé et un fichier remplacé. Chaque étape doit ajouter, mettre à jour ou retirer l’enregistrement de récupération correspondant dans le délai convenu.
Les règles d’accès tiennent pendant la récupération
La même question ne doit pas exposer du contenu Drupal restreint à tous les utilisateurs. Le pilote teste la récupération sous plusieurs contextes authentifiés et anonymes.
Les règles d’accès tiennent pendant la récupération.
Des utilisateurs test avec des rôles, groupes, abonnements ou grants différents posent les mêmes questions. Les résultats montrent si chaque utilisateur ne reçoit que les sources disponibles dans sa session Drupal et si les liens cités restent protégés à l’ouverture.

Les réponses renvoient vers Drupal
Les utilisateurs doivent voir quelles pages ou fichiers Drupal fondent chaque réponse. Le pilote relie la sortie du chatbot à des destinations live que votre équipe peut ouvrir et vérifier.
Les réponses renvoient vers Drupal.
Un jeu de questions fixes vérifie URLs citées, affirmations non étayées, comportement sans réponse, temps de réponse et échecs de récupération. La revue produit une liste de corrections requises avant un déploiement plus large.
Cadrer un pilote chatbot Drupal ciblé
Envoyez l’URL Drupal, les publics qui doivent utiliser le chatbot et les collections de contenu qui doivent fonder les réponses. Nous définirons le périmètre du connecteur et les tests d’acceptation pour un pilote sur des scénarios d’accès réels. Commencez avec un périmètre de contenu, plusieurs rôles utilisateur et des citations que vous pouvez vérifier dans Drupal.
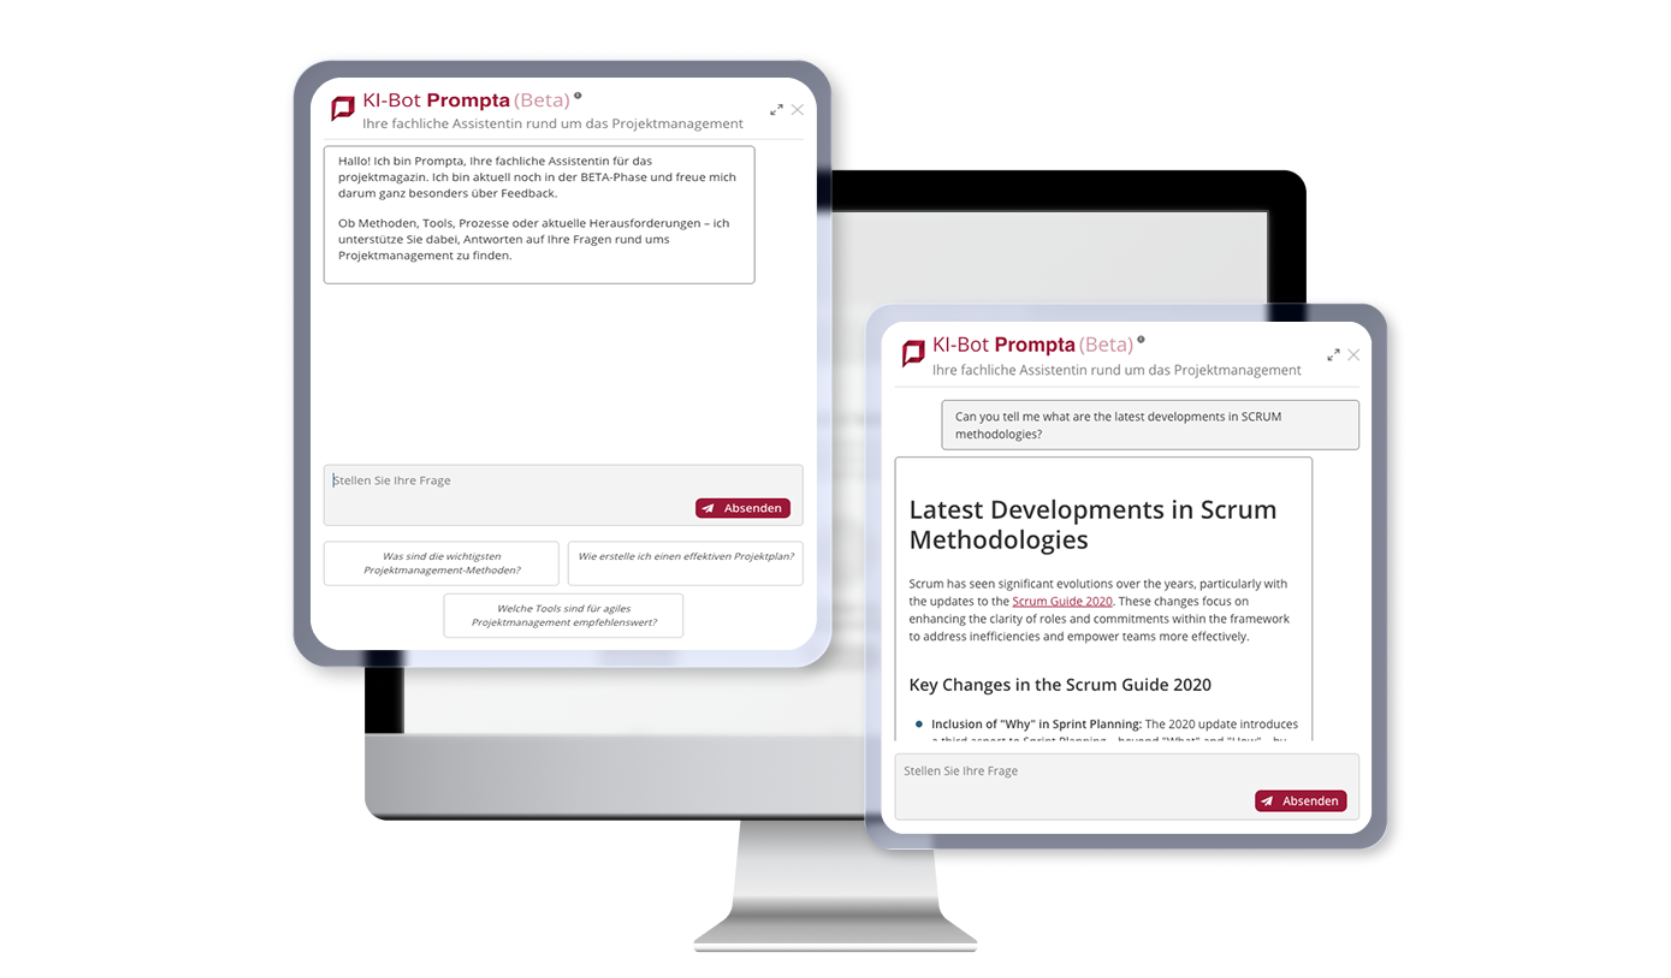
ProjektMagazin: contenu Drupal connecté à un chatbot documentaire
ProjektMagazin exploite une plateforme de connaissances Drupal avec articles, documents, modèles et méthodes. Nous avons connecté son chatbot via des API JSON et conservé les métadonnées nécessaires à la récupération et à l’attribution des sources.
Les mises à jour Drupal déclenchent une réindexation via webhooks, tandis qu’une synchronisation planifiée rattrape les changements manqués. Le système achemine les questions, cite les sources, enregistre les retours et fournit des données d’exploitation pour les ajustements ultérieurs.
Lire le case study du chatbot documentaire IA ProjektMagazin
Avez-vous besoin d’un autre service Drupal IA?
Cette page traite de l’intégration chatbot sur un site Drupal existant. Si votre problème principal est ailleurs, utilisez l’une de ces routes. N’utilisez pas cette page pour une offre chatbot générique en dehors de votre modèle de contenu Drupal.

Quand cette page ne convient pas
Si vous avez besoin d’un produit chatbot générique en dehors de votre modèle de contenu Drupal, commencez par le hub Développement IA pour Drupal et choisissez la voie adaptée à votre plateforme.

Automatisation éditoriale du contenu dans Drupal
Si la priorité est l’import Word et PDF, les traductions, les métadonnées ou le texte alternatif dans les workflows éditoriaux, consultez Automatisation Drupal IA pour les équipes éditoriales.

Generative engine optimization pour Drupal
Si l’objectif est d’améliorer la façon dont les moteurs de réponses citent vos pages Drupal publiques, consultez Services Generative Engine Optimization pour Drupal.

Comparer toutes les voies Drupal IA
Pour une vue d’ensemble de l’automatisation, de l’intégration chatbot et du GEO sur une plateforme Drupal, consultez Développement IA pour Drupal.
Questions fréquentes sur l’intégration chatbot IA Drupal
En général, oui. Nous examinons d’abord la version Drupal, le modèle de contenu, les entités personnalisées, les fichiers, les API, la stack de recherche, l’authentification, la logique d’accès et l’hébergement. Cette revue montre quels composants existants peuvent rester et où le site a besoin d’un connecteur ou d’un changement de configuration.
Cela dépend du modèle de contenu et des exigences d’accès. Des modules existants peuvent couvrir l’interface, la connexion au fournisseur ou une recherche de base. Les sites avec Paragraphs imbriqués, entités personnalisées, abonnements, fichiers externes ou grants personnalisés ont souvent besoin d’un mapping et d’une synchronisation supplémentaires.
Elle peut réutiliser l’index actuel ou des parties du pipeline de recherche. Nous vérifions si les champs requis sont présents, si les mises à jour sont assez rapides, si les filtres de langue et d’accès s’appliquent et si des métadonnées source adaptées aux citations sont renvoyées.
Le chemin de mise à jour doit retirer les enregistrements de récupération correspondants. La suppression pilotée par événements couvre les changements courants, tandis qu’une réconciliation compare l’index à l’état Drupal actuel et rattrape les opérations manquées ou en échec.
Les filtres de récupération utilisent l’identité, le rôle, le groupe, l’abonnement ou le grant approuvé avant qu’un passage n’atteigne le modèle. Un lien cité reste protégé par le contrôle d’accès propre à Drupal. Le pilote teste plusieurs utilisateurs et des changements de permissions récents.
Oui, si le connecteur conserve chaque variante linguistique et son état de publication. La récupération peut filtrer ou classer selon la langue de l’utilisateur, tandis que les citations pointent vers la traduction Drupal correspondante. Le pilote doit aussi tester les traductions manquantes et de repli.